
Fluxo
Distinguir texto selecionável de um PDF escaneado
Descubra se um PDF tem texto selecionável, extraia o que a Kitly consegue ler e pare quando a página for só uma imagem.
Objetivo
Extrair o texto de um PDF de uma página em que duas frases ficam lado a lado, e confirmar que um PDF feito só de imagem não devolve essas palavras.
Esta página é HTML estático. PDF para Texto precisa de JavaScript porque o PDF.js lê o arquivo no navegador. Dá para ler os dois resultados e o texto já extraído com JavaScript desligado. A ferramenta não envia o PDF.
Entradas
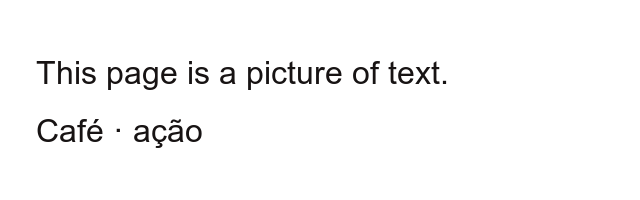
Os dois PDFs são originais deste guia. product-note.pdf é um PDF 1.4 com Helvetica e codificação WinAnsi; a fonte padrão não vai embutida. scan-only.pdf é a imagem scan-only.png colocada numa página, sem operadores de texto e sem fonte embutida. A imagem foi desenhada com Arial só para rasterizar duas frases; o arquivo publicado não contém a fonte.
Decisões
Extrair primeiro o PDF com texto
Se aparecer texto, confira a ordem de leitura antes de reutilizar as frases. Neste arquivo, as duas frases da segunda linha foram desenhadas em x=72 e x=300, na mesma altura y=680, e saem numa linha só.
Parar quando não houver texto selecionável
Uma página em branco no resultado não é um pedido para tentar de novo. PDF para Texto não faz OCR. As palavras visíveis na imagem precisam ser digitadas em outro lugar, se você precisar delas.
Não encadear com outra ferramenta
A Kitly não passa o texto extraído para outro utilitário. Copie ou baixe o TXT quando houver texto. No PDF só de imagem, copiar e baixar ficam desativados.
Sequência verificada
Escolher um PDF novo apaga o texto anterior. Rode um arquivo de cada vez e leia o estado antes de trocar.
- Baixe product-note.pdf e scan-only.pdf acima. Abra scan-only.png se quiser ver as frases da imagem.
- Abra PDF para Texto e escolha product-note.pdf. Clique em Extrair texto.
- Páginas mostra 1. O texto extraído é exatamente o bloco abaixo. Baixe product-note.txt se quiser esses caracteres num arquivo. Copiar fica disponível porque havia texto.
- Escolha scan-only.pdf. A troca de arquivo limpa a extração anterior. Clique em Extrair texto de novo.
- Páginas mostra 1. A área de texto fica vazia. O estado e o erro mostram: Nenhum texto selecionável foi encontrado. Este PDF pode ser escaneado ou baseado em imagem. Copiar e baixar continuam desativados.
- Compare com scan-only.png. A imagem contém This page is a picture of text. e Café · ação. Essas frases não aparecem na extração. Digite-as você mesmo se precisar delas.
Resultado observado
Extraído com pdfjs-dist 4.10.38, getTextContent, e a mesma junção da ferramenta: cada item de texto ganha uma quebra de linha quando hasEOL é verdadeiro e um espaço quando não é. Espaços repetidos são reduzidos.
Texto extraído de product-note.pdf
Kitly product note
Cor: café Ação: publicar| product-note.pdf | 718 bytes, 1 página. Itens de texto em (72, 720), depois uma quebra, depois Cor: café em (72, 680) e Ação: publicar em (300, 680). |
|---|---|
| product-note.txt | 46 bytes. Os mesmos caracteres do bloco acima, sem uma quebra de linha extra depois de publicar. |
| scan-only.pdf | 9139 bytes, mostrado como 8.9 KB, 1 página. A caixa da página é 640×200. getTextContent não devolveu itens de texto. |
| scan-only.png | 640×200, 16838 bytes, mostrado como 16.4 KB. As frases em inglês estão visíveis na imagem e ausentes na extração. |
| Resposta da ferramenta no scan | Páginas: 1. Texto vazio. Estado e erro: Nenhum texto selecionável foi encontrado. Este PDF pode ser escaneado ou baseado em imagem. Copiar e baixar ficam desativados. |
Limites
- A ordem visual em colunas não é preservada. As duas frases da mesma linha viram uma linha só.
- Não há OCR. Uma página que você consegue ler na imagem pode produzir texto vazio.
- A ferramenta implementa limites de 25 MB e 200 páginas, e uma mensagem separada para PDF criptografado. Esses casos não foram executados de novo neste guia.
- A medição usou a mesma função de junção do componente, com o worker desativado no script. A página da ferramenta usa o worker empacotado da mesma versão 4.10.38.
- O texto do PDF de amostra mistura uma linha em inglês com Cor: café e Ação: publicar. O resultado não foi traduzido; é a string observada.
Ferramenta neste idioma
Só uma ferramenta entra neste fluxo. Não há uma segunda etapa automática.
- PDF para Texto Lê texto selecionável no navegador e explica quando a página não tem texto para extrair.