
Flujo
Distinguir texto seleccionable de un PDF escaneado
Averigua si un PDF tiene texto seleccionable, extrae lo que Kitly puede leer y detente cuando la página sea solo una imagen.
Objetivo
Extraer el texto de un PDF de una página en el que dos frases quedan una al lado de la otra, y confirmar que un PDF hecho solo de imagen no devuelve esas palabras.
Esta página es HTML estático. PDF a Texto necesita JavaScript porque PDF.js lee el archivo en el navegador. Puedes leer los dos resultados y el texto ya extraído con JavaScript desactivado. La herramienta no envía el PDF.
Entradas
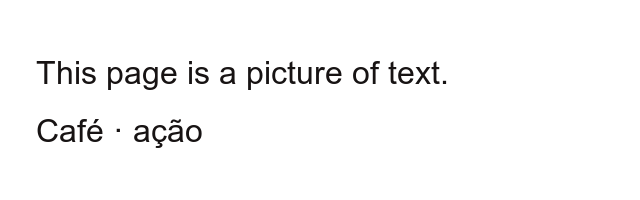
Los dos PDF son originales de esta guía. product-note.pdf es un PDF 1.4 con Helvetica y codificación WinAnsi; la fuente estándar no va incrustada. scan-only.pdf es la imagen scan-only.png colocada en una página, sin operadores de texto y sin fuente incrustada. La imagen se dibujó con Arial solo para rasterizar dos frases; el archivo publicado no contiene la fuente.
Decisiones
Extraer primero el PDF con texto
Si aparece texto, revisa el orden de lectura antes de reutilizar las frases. En este archivo, las dos frases de la segunda línea se dibujaron en x=72 y x=300, a la misma altura y=680, y salen en una sola línea.
Detenerse cuando no hay texto seleccionable
Un área vacía no es una invitación a reintentar. PDF a Texto no hace OCR. Las palabras visibles en la imagen hay que escribirlas en otro lugar, si las necesitas.
No encadenar con otra herramienta
Kitly no pasa el texto extraído a otra utilidad. Copia o descarga el TXT cuando hay texto. En el PDF solo de imagen, copiar y descargar quedan desactivados.
Secuencia verificada
Elegir un PDF nuevo borra el texto anterior. Procesa un archivo cada vez y lee el estado antes de cambiar.
- Descarga product-note.pdf y scan-only.pdf arriba. Abre scan-only.png si quieres ver las frases de la imagen.
- Abre PDF a Texto y elige product-note.pdf. Haz clic en Extraer texto.
- Páginas muestra 1. El texto extraído es exactamente el bloque de abajo. Descarga product-note.txt si quieres esos caracteres en un archivo. Copiar queda disponible porque había texto.
- Elige scan-only.pdf. Cambiar de archivo limpia la extracción anterior. Haz clic en Extraer texto otra vez.
- Páginas muestra 1. El área de texto queda vacía. El estado y el error muestran: No se encontró texto seleccionable. Este PDF puede estar escaneado o basado en imágenes. Copiar y descargar siguen desactivados.
- Compara con scan-only.png. La imagen contiene This page is a picture of text. y Café · ação. Esas frases no aparecen en la extracción. Escríbelas tú mismo si las necesitas.
Resultado observado
Extraído con pdfjs-dist 4.10.38, getTextContent, y la misma unión de la herramienta: cada elemento de texto recibe un salto de línea cuando hasEOL es verdadero y un espacio cuando no lo es. Los espacios repetidos se reducen.
Texto extraído de product-note.pdf
Kitly product note
Cor: café Ação: publicar| product-note.pdf | 718 bytes, 1 página. Elementos de texto en (72, 720), luego un salto, luego Cor: café en (72, 680) y Ação: publicar en (300, 680). |
|---|---|
| product-note.txt | 46 bytes. Los mismos caracteres del bloque de arriba, sin un salto de línea extra después de publicar. |
| scan-only.pdf | 9139 bytes, mostrado como 8.9 KB, 1 página. La caja de la página es 640×200. getTextContent no devolvió elementos de texto. |
| scan-only.png | 640×200, 16838 bytes, mostrado como 16.4 KB. Las frases en inglés están visibles en la imagen y ausentes en la extracción. |
| Respuesta de la herramienta en el escaneo | Páginas: 1. Texto vacío. Estado y error: No se encontró texto seleccionable. Este PDF puede estar escaneado o basado en imágenes. Copiar y descargar quedan desactivados. |
Límites
- El orden visual en columnas no se conserva. Las dos frases de la misma línea se vuelven una sola línea.
- No hay OCR. Una página que puedes leer en la imagen puede producir texto vacío.
- La herramienta implementa límites de 25 MB y 200 páginas, y un mensaje distinto para un PDF cifrado. Esos casos no se volvieron a ejecutar en esta guía.
- La medición usó la misma función de unión del componente, con el worker desactivado en el script. La página de la herramienta usa el worker empaquetado de la misma versión 4.10.38.
- El texto del PDF de muestra mezcla una línea en inglés con Cor: café y Ação: publicar. El resultado no se tradujo; es la cadena observada.
Herramienta en este idioma
Solo una herramienta entra en este flujo. No hay un segundo paso automático.
- PDF a Texto Lee texto seleccionable en el navegador y explica cuándo la página no tiene texto para extraer.